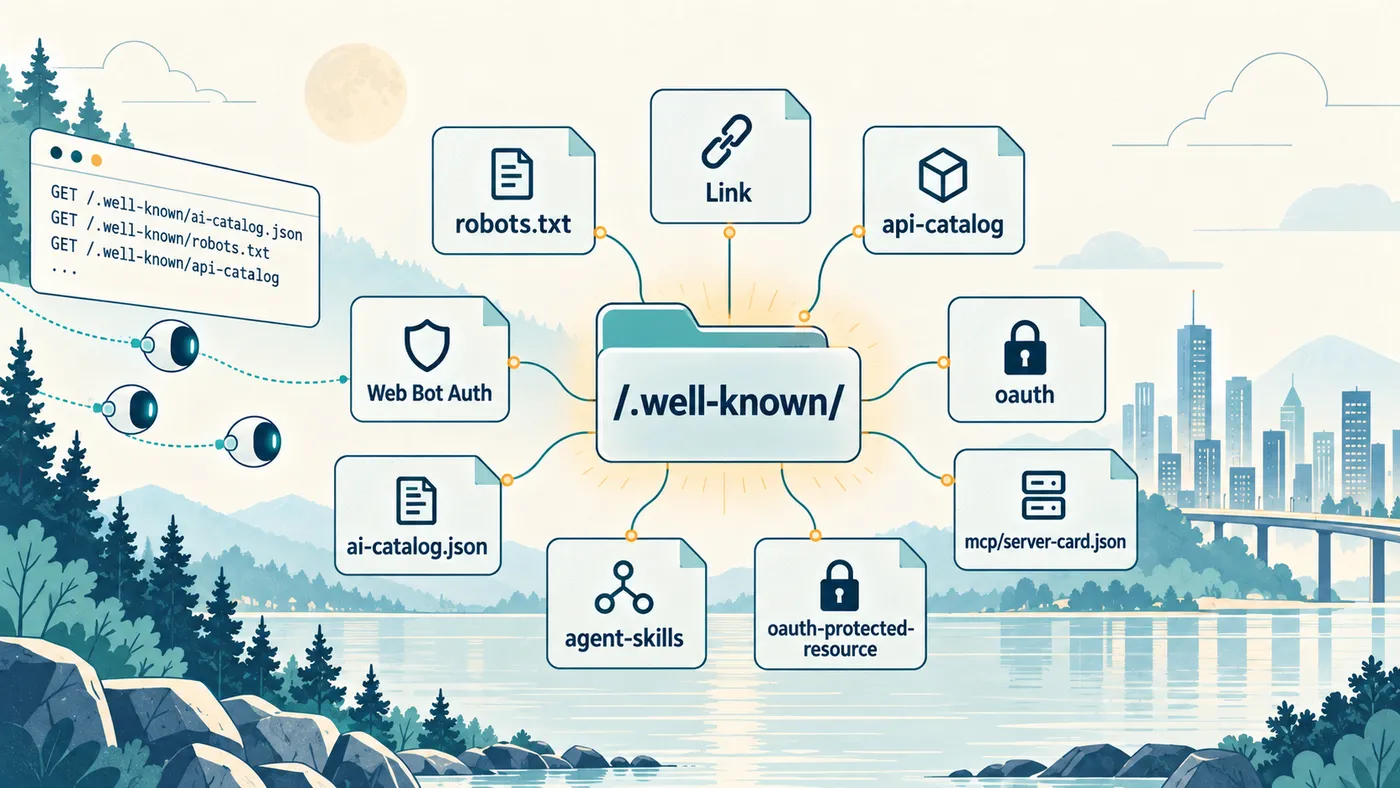
La Explosión de .well-known: Guía de Campo a los Nuevos Estándares para Agentes
Mira los registros de un sitio cualquiera a las tres de la mañana y vas a encontrar visitas que no encajan: docenas de páginas leídas en segundos, ni un clic, ni una imagen descargada, y se van. No son personas. Tampoco son los crawlers de siempre, que solo traían contenido para un buscador. Son agentes de IA (programas que llegan a leer y a actuar) y cada mes llegan más.
Ese visitante no ve tu sitio. No renderiza el diseño, no sigue la navegación, no se deja seducir por el copy. Y aun así decide cosas sobre ti: cuánto de tu contenido usar, cómo citarte, si volverse cliente o pasar de largo. La pregunta de esta guía es sencilla: ¿dónde le dejas las instrucciones a alguien que no entra por la puerta principal?
La respuesta lleva una década funcionando y tú ya la usaste cien veces, sin saberlo. Cuando entras a una página desconocida y le das a «Iniciar sesión con Google», el botón funciona porque Google (y Apple, y Microsoft) publican sus instrucciones siempre en la misma carpeta, en la misma ruta: /.well-known/. La página conoce el dominio de Google; con eso le basta, porque la regla dice dónde está todo lo demás. La RFC 8615 (los RFC son los documentos con los que Internet escribe sus reglas) reservó esa carpeta para exactamente eso: lo que un sitio quiere que el mundo sepa de antemano, vive aquí. Ahí viven openid-configuration, security.txt para reportar vulnerabilidades, los desafíos de ACME que renuevan tus certificados mientras duermes.
Detalle práctico, porque alguien siempre lo prueba: la carpeta no se abre ni se lista. Si pides google.com/.well-known/ en el navegador, te devuelve un 404: no es una carpeta de tu computador, es una convención de rutas. Cada estándar define el nombre exacto del archivo que vive dentro, y cada dominio publica solo los suyos: las instrucciones de inicio de sesión de Google están en accounts.google.com/.well-known/openid-configuration, no en google.com. Ahí sí: JSON crudo, a la vista de cualquiera.
Lo nuevo no es la carpeta. Es quién se mudó a ella. Durante 2025 y 2026 se llenó de archivos escritos para el visitante de las tres de la mañana, y esta guía los recorre todos, en el orden en que los implementarías en un sitio nuevo: del archivo más barato al más caro.
Dónde está el terreno hoy
Antes de entrar archivo por archivo, un retrato del terreno. Se mueve rápido. Cuatro cosas definieron el año, todas verificadas cuando escribí esto, en septiembre de 2026:
- El tablero creció. isitagentready.com, el tablero de Cloudflare (la empresa de infraestructura web) que mide qué tan listo para agentes está un sitio, pasó de 8 verificaciones a 22, agrupadas en cinco ejes: qué tan fácil es encontrarte, qué tan accesible es tu contenido, cómo controlas los bots, qué protocolos publicas y comercio.
- Llegaron los pagos. Hasta ayer, el agente solo leía; ahora también compra. Cuatro formatos compiten por su billetera (x402, UCP, MPP y ACP) y forman un eje completo del tablero, nuevo de fábrica.
- Web Bot Auth se volvió real. Pasó de promesa en el roadmap a verificación del tablero, y ya tiene grupo de trabajo propio en la IETF (el organismo que estandariza Internet).
- MCP publicó el spec 2026-07-28. El protocolo con el que los agentes hablan con herramientas externas se reescribió sin estado: sin saludo inicial, sin sesiones que recordar.
Una promesa antes de empezar: si no programas, esto también es para ti. Quédate en los «qué es» y «por qué existe» de cada sección: ahí vive toda la narrativa, y el código puede esperar. Si sí programas, cada sección es autocontenida: qué es / por qué existe / ejemplo mínimo válido / trampas comunes / dónde aprender más. Salta entre ellas.
1. Content Signals en robots.txt
La primera conversación con quien llega: antes de leer una sola palabra tuya, descubre qué puede hacer con ella.
Qué es
Una línea en robots.txt — el pequeño archivo de texto que todo sitio deja en su raíz para hablarle a los programas que lo recorren — declarando tus preferencias para el uso de tu contenido por IA: entrenamiento, indexación en buscadores, uso como insumo de una respuesta generada.
Por qué existe
robots.txt tradicionalmente le decía a los crawlers si podían traer el contenido. Content Signals extiende eso a qué pueden hacer con lo que traen. Formaliza la diferencia entre «indéxame por favor» y «por favor no me entrenes»: una distinción que noindex y allow/disallow no pueden expresar.
Ejemplo mínimo válido
User-agent: *
Content-Signal: ai-train=no, search=yes, ai-input=yes
Las tres señales (ai-train, search, ai-input) deben aparecer. Hay una cuarta en camino: use, que declara cómo se consume el contenido (immediate, reference o full); ya aparece en los bloques que Cloudflare gestiona automáticamente.
Trampas comunes
- Poner
Content-Signal:fuera de un bloqueUser-agent:— invisible para los crawlers. - Omitir una de las tres señales, o escribir
ai-train=no,search=yessin espacio después de la coma. - La trampa de las dos capas. Si activas la gestión automática de Content Signals en Cloudflare, tu
robots.txttermina con dos bloques que escriben la misma directiva — el gestionado arriba, el tuyo abajo. En cabuya.org convivenai-train=no(gestionado) yai-train=yes(el mío). Al preparar este post encontré exactamente eso, y no tengo una respuesta limpia: cada crawler resuelve bloques duplicados a su manera. Lo que sí sé es que una política ambigua es peor que una política que te desagrade. Decide qué capa es la dueña de la señal.
Dónde aprender más
- contentsignals.org
- Draft IETF
- AI Crawl Control de Cloudflare
2. Link headers de respuesta (RFC 8288)
Un letrero en cada respuesta: «el catálogo está por ahí, las instrucciones por allá» — sin que nadie tenga que abrir el HTML.
Qué es
Cada respuesta que sirve un sitio viaja en dos partes: el cuerpo — lo que se ve — y los encabezados, unas líneas de metadatos que viajan antes, como los datos del sobre. Un Link header es una línea de ese sobre: apunta a documentos compañeros legibles por máquina. Piénsalo como las etiquetas con las que el HTML dice «mi hoja de estilos vive allá», pero promovidas al sobre — así, el cliente que nunca abre el cuerpo igual se entera de dónde está todo.
Por qué existe
Los agentes no siempre renderizan la página — a veces piden solo los encabezados (un HEAD: el equivalente a asomarse y preguntar «¿qué hay aquí?» sin descargar nada) y deciden con eso. Los Link headers les permiten descubrir tu catálogo de APIs, tu tarjeta MCP o tu índice de skills sin traer el HTML.
Ejemplo mínimo válido
Link: </.well-known/api-catalog>; rel="api-catalog"Valores de rel útiles: api-catalog, service-desc, service-doc, describedby. Uno basta; varios están bien. Así se ve el de cabuya.org en producción, servido en cada respuesta:
Link: </.well-known/api-catalog>; rel="api-catalog"; type="application/linkset+json",
      </openapi.json>; rel="service-desc"; type="application/openapi+json",
      </llms.txt>; rel="describedby"; type="text/plain"
Trampas comunes
- Faltan los brackets angulares alrededor de la URL, o el punto y coma antes de
rel=. - Apuntar
rela una URL que devuelve 404. - Emitirlos solo en
/y no en subrutas por idioma como/es/.
Dónde aprender más
- RFC 8288 (Web Linking)
- RFC 9727 §3 (registro del rel
api-catalog) - Registro de Link Relations de IANA
3. API Catalog (RFC 9727 + Linkset RFC 9264)
Todo lo que tu sitio sabe hacer, listado en un solo archivo que se lee sin preguntarte nada.
Qué es
Un documento JSON (el formato de texto que las máquinas leen sin esfuerzo) en /.well-known/api-catalog, listando las APIs públicas del sitio: las cosas que un programa puede pedirle (datos, búsquedas, resultados). Cada entrada enlaza su descripción legible por máquina (OpenAPI — el formato estándar para describir APIs) y su documentación humana.
Por qué existe
Un solo puntero a tu spec OpenAPI no basta — los sitios grandes tienen varias APIs, cada una con documentación distinta. El catálogo usa el formato linkset (una lista de enlaces estandarizada en JSON) para que cualquier herramienta consuma todas esas descripciones de la misma manera.
Ejemplo mínimo válido
{
  "linkset": [
    {
      "anchor": "https://api.example.com/users",
      "links": [
        { "rel": "service-desc", "href": "https://api.example.com/openapi.json" },
        { "rel": "service-doc", "href": "https://api.example.com/docs" }
      ]
    }
  ]
}
El catálogo de cabuya.org (recortado) apunta al OpenAPI, a la documentación y a los JSON Schema del protocolo — tres anchor para tres superficies:
{
  "linkset": [
    {
      "anchor": "https://cabuya.org/api/validate",
      "service-desc": [{ "href": "https://cabuya.org/openapi.json" }],
      "service-doc": [{ "href": "https://cabuya.org/developers/validator.md" }]
    }
  ]
}
Trampas comunes
- El Content-Type equivocado. Debe ser
application/linkset+json, noapplication/json. Esta falla en silencio: el archivo se ve perfecto en el navegador y ningún cliente lo acepta. - Un array
linksetvacío, o sinservice-desc/service-doc. - Enlazar a un spec OpenAPI que en realidad no has escrito.
Dónde aprender más
- RFC 9727 (The Linkset API Catalog)
- RFC 9264 (Linksets) — el Apéndice A del 9727 tiene ejemplos completos
4. OAuth Authorization Server Metadata (RFC 8414) / OIDC Discovery
Aquí vuelve a aparecer: la historia del botón con la que abrí este post es esta sección, vista desde el otro lado de la puerta.
Qué es
Publicar la configuración de tu servidor de autorización OAuth (OAuth es el estándar con el que una app pide permisos a otra sin compartir contraseñas) en una ruta fija, para que los clientes descubran los endpoints programáticamente.
Por qué existe
Ningún agente puede traer de fábrica las direcciones de tu puerta — los endpoints: las rutas exactas donde tu sitio acepta cada tipo de petición; cada sitio tiene las suyas. Con estos metadatos, un solo pedido le basta para saber exactamente cómo empezar a autenticarse contigo.
Ejemplo mínimo válido
{
  "issuer": "https://your-domain.com",
  "authorization_endpoint": "https://your-domain.com/authorize",
  "token_endpoint": "https://your-domain.com/token",
  "jwks_uri": "https://your-domain.com/.well-known/jwks.json",
  "grant_types_supported": ["authorization_code"],
  "response_types_supported": ["code"]
}
Seis campos requeridos, servidos en /.well-known/oauth-authorization-server o /.well-known/openid-configuration. La versión que sirve cabuya.org declara exactamente lo que existe: un solo credencial, y lo que compra:
{
  "issuer": "https://cabuya.org",
  "token_endpoint": "https://cabuya.org/oauth/token",
  "grant_types_supported": ["client_credentials"],
  "scopes_supported": ["validate:extended"],
  "service_documentation": "https://cabuya.org/auth.md"
}
Traducción: estos archivos le dan al agente el mapa de la puerta — dónde se pide un token y qué se puede hacer con él. La llave sigue siendo cosa tuya.
Trampas comunes
- Publicar endpoints que no existen. En un sitio sin OAuth real, lo correcto es documentar rutas reservadas: un campo
_commentcumple el spec. - Omitir uno de los seis campos requeridos.
- Contar con el registro dinámico de clientes (RFC 7591) para siempre: el spec MCP 2026-07-28 lo deprecó para implementaciones nuevas, con remoción después del verano de 2027. Si estás empezando, prefiere clientes pre-registrados.
Dónde aprender más
- RFC 8414 (OAuth 2.0 Authorization Server Metadata)
- OpenID Connect Discovery 1.0
- Managed OAuth for Access de Cloudflare
5. OAuth Protected Resource Metadata (RFC 9728)
La otra mitad de la conversación: no «dónde consigo una llave», sino «qué abre esa llave aquí».
Qué es
El documento compañero del anterior: declara qué recursos están protegidos y qué servidores de autorización emiten tokens para ellos.
Por qué existe
Los metadatos del servidor de autorización responden “¿dónde consigo un token?”. Los del recurso protegido responden “¿qué puedo hacer con uno aquí?”. Un agente que descubre ambos puede planear el flujo completo.
Ejemplo mínimo válido
{
  "resource": "https://your-domain.com",
  "authorization_servers": ["https://your-oauth-provider.com"]
}
Dos campos requeridos. En un sitio de contenido sin recursos protegidos, declarar que el recurso eres tú mismo es una redundancia deliberada que el spec permite. Así la sirve cabuya.org:
{
  "resource": "https://cabuya.org",
  "authorization_servers": ["https://cabuya.org"],
  "scopes_supported": ["validate:extended"]
}
Trampas comunes
- Listar servidores de autorización inexistentes o inalcanzables.
- Ruta equivocada: debe ser exactamente
/.well-known/oauth-protected-resource, sin extensión.json. - Olvidar el
WWW-Authenticate: resource_metadataen las respuestas 401 — es cómo un agente que llegó sin saber descubre el documento.
Dónde aprender más
- RFC 9728 (OAuth 2.0 Protected Resource Metadata)
6. MCP Server Card (SEP-1649)
Los agentes no solo leen sitios: usan herramientas. Esta tarjeta dice dónde están las tuyas.
Qué es
Un documento JSON en /.well-known/mcp/server-card.json que declara tu sitio como una superficie compatible con MCP — qué capacidades sirve y dónde conectar.
Por qué existe
MCP (Model Context Protocol) se volvió el lenguaje compartido con el que los agentes hablan con herramientas externas. La tarjeta hace que un sitio MCP sea descubrible en una ruta conocida, sin configurar cada agente a mano.
Qué cambió en el spec
La versión 2026-07-28 reescribió el transporte: MCP ahora es sin estado — sin handshake de inicialización (la salutación con la que dos programas se ponen de acuerdo antes de hablar), sin Mcp-Session-Id, con encabezados nuevos (Mcp-Method, Mcp-Name) para que gateways y WAF (los filtros que inspeccionan el tráfico de red) decidan sin leer el cuerpo de la petición. El transporte HTTP+SSE quedó deprecado. La tarjeta sigue siendo una propuesta (la SEP-1649), ahora acompañada de un draft IETF para un esquema URI mcp://. El estándar se está asentando; los detalles todavía se mueven.
Ejemplo en producción
{
  "serverInfo": { "name": "cabuya-org", "title": "cabuya.org site tools", "version": "0.1.0" },
  "transport": { "type": "streamable-http", "endpoint": "https://cabuya.org/mcp" },
  "capabilities": { "tools": {} },
  "tools": [
    { "name": "validate_cabuya_feed" },
    { "name": "read_cabuya_page_as_markdown" }
  ],
  "authentication": { "type": "none" }
}
Nota el detalle: el SEP define capabilities como una lista simple de palabras; cabuya.org sirve un objeto (pares de nombre y valor) y el escáner pasa ambas formas. Estamos en esa etapa incómoda donde el spec, los escáneres y la producción todavía no dicen lo mismo. Escribe lo que el SEP pide y tolera lo que encuentres.
Trampas comunes
- Ruta anidada equivocada — es
/.well-known/mcp/server-card.json, no/.well-known/mcp.json. - Un array
capabilitiesvacío. - Declarar capacidades que tu sitio no sirve por MCP.
Dónde aprender más
- Model Context Protocol — spec
- SEP-1649 / server card
- The next generation of MCP (Cloudflare, sobre 2026-07-28)
7. Agent Skills Discovery (Cloudflare RFC v0.2.0)
Una herramienta se llama. Una skill se aprende. Este índice dice dónde vive lo que tu sitio puede enseñar.
Qué es
Un índice JSON en /.well-known/agent-skills/index.json que lista skills — procedimientos documentados que un agente puede leer, guardar y seguir — cada uno apuntando a su SKILL.md con un hash SHA-256: la huella criptográfica de los bytes realmente servidos.
Por qué existe
Una herramienta es algo que un agente puede llamar. Una skill es conocimiento componible encima: instrucciones que el agente lee y ejecuta cuando las necesita. El índice estándariza dónde encontrarlas y el hash permite verificar que no cambiaron en el camino.
Ejemplo mínimo válido
{
  "$schema": "https://schemas.agentskills.io/discovery/0.2.0/schema.json",
  "skills": []
}
Un skills[] vacío es válido. El de cabuya.org lista dos, con hash y licencia (recortado):
{
  "skills": [
    {
      "name": "publish-a-cabuya-feed",
      "type": "skill",
      "description": "Publish emergency-aid data as a conforming feed and measure it with the public validator.",
      "url": "https://cabuya.org/.well-known/agent-skills/publish-a-feed/SKILL.md",
      "sha256": "7777afc5fcf6c2f2...",
      "license": "CC0-1.0"
    }
  ]
}
¿Notaste? El spec canónico llama al campo digest con prefijo sha256:; la producción a veces lo llama sha256 a secas. El escáner acepta ambas. Si escribes un cliente, tolera la varianza — es un draft, y los drafts mutan.
Trampas comunes
- Nombre de skill con mayúsculas o espacios (minúsculas, números, guiones; 1–64 caracteres).
- Hash calculado sobre los bytes locales en vez de los bytes realmente servidos — difieren si tu servidor recomprime el contenido.
- Confundir
type: "skill-md"(un solo archivo) contype: "archive"(un.tar.gzmulti-archivo).
Dónde aprender más
8. WebMCP (navegador)
Todo lo anterior era para agentes que llegan desde afuera. ¿Y si el agente ya está dentro de tu página?
Qué es
Una API de navegador — navigator.modelContext.registerTool() — con la que una página publica herramientas que un agente corriendo dentro del navegador puede llamar. MCP sobre el contexto de una página en vez de sobre un servidor.
Por qué existe
Cuando el agente corre en el navegador del usuario (una extensión, un asistente integrado), tiene acceso completo a la sesión — cookies, estado, todo. WebMCP le da a la página una forma de decir “estas acciones expongo” sin convertirlas en APIs públicas.
Ejemplo mínimo válido
navigator.modelContext.registerTool({
  name: 'search',
  description: 'Search site content',
  inputSchema: {
    type: 'object',
    properties: { q: { type: 'string' } },
    required: ['q'],
  },
  execute: async ({ q }) => { /* ... */ },
}, { signal: abortController.signal });
Cuatro propiedades por herramienta: name, description, inputSchema, execute. Pasa la señal del AbortController para revocar el registro al desmontar.
Trampas comunes
- Registrar herramientas en un script que corre tarde — después de que el escáner tomó su foto de la página. Asegúrate de que el registro ocurra al cargar, no en un momento diferido.
- Exponer operaciones de escritura sin consentimiento explícito. Mantén la superficie de solo lectura al principio.
- Un
inputSchemaque no es JSON Schema válido.
Dónde aprender más
9. Web Bot Auth (ya no es bonus)
Cualquiera puede tocar la puerta. Esto es cómo un agente demuestra quién es cuando toca.
Qué es
Un directorio en /.well-known/http-message-signatures-directory con las llaves públicas que los agentes usan para firmar sus peticiones HTTP. Le permite a un sitio verificar “esta petición viene realmente del agente que dice ser”.
Por qué existe
La identificación de bots se basa en IP y User-Agent, ambos suplantables. Web Bot Auth propone firmas criptográficas para que los agentes prueben su identidad. Esto pasó de roadmap a verificación real del tablero (pedir un JWKS con al menos una llave) y ya tiene un grupo de trabajo propio en la IETF. El programa de bots verificados de Cloudflare ya verifica con criptografía, no con listas de IP.
Qué pide la verificación
- Publicar un JWKS (un conjunto de llaves públicas JSON) en la ruta well-known.
- Firmar las peticiones que envía tu bot, incluyendo los encabezados
Signature-AgentySignature-Input.
Dónde aprender más
- Web Bot Auth en Cloudflare
- The age of agents (el origen, agosto 2025)
10. Lo último que llegó: pagos, agentes entre sí y DNS
El tablero corre 22 verificaciones; estas cinco son las más recientes. Una línea cada una, para que sepas que existen:
- A2A Agent Card —
/.well-known/agent-card.json: descubrimiento de agente a agente, para agentes que se buscan entre sí (spec). - ARD —
/.well-known/ai-catalog.json: un manifiesto unificado que lista tus servidores MCP, agentes A2A, skills y APIs en un solo documento (spec, aún v0.9). - DNS-AID — descubrimiento por DNS (el sistema que traduce dominios en direcciones): registros
SVCBbajo el namespace_agentsde tu dominio, para que un agente encuentre tus endpoints antes de hacer su primera petición HTTP. - auth.md — un
/auth.mden la raíz que explica tu autenticación en prosa para agentes (la propuesta). - Comercio — cuatro formatos que compiten por la billetera del agente: x402 (de Coinbase, pagos HTTP nativos con respuesta 402), UCP, MPP y ACP.
El tablero arrancó con 8 verificaciones; hoy son 22. La carpeta sigue explotando.
11. Cabuya: nacer con la recepción abierta
Cabuya es un protocolo abierto de interoperabilidad para aplicaciones de ayuda humanitaria que construí. El problema es sencillo: en cada emergencia, los equipos construyen sus propios mapas y directorios, a veces para la misma ciudad, y los datos quedan atrapados en cada app. Cabuya define un formato común para los lugares donde corre la ayuda (albergues, centros de acopio, puntos de servicio) y una ruta fija para publicarlos. Cualquier app puede leer lo que cualquier otra publicó. Los datos personales quedan fuera por diseño, no por buenas intenciones. Todo es CC0 — no hay a quién pedirle permiso.
¿Por qué esto le importa a un protocolo recién nacido? Porque un sitio nuevo no tiene enlaces, ni reputación, ni historial. Un protocolo nuevo no tiene nada que recomendarlo excepto ser fácil de encontrar por quien llega sin contexto. La recepción bien atendida no es un lujo — es la única distribución que tiene el primer día.
Así que cabuya.org sirve la familia completa: encabezados Link en cada respuesta; el catálogo de APIs con su Content-Type correcto apuntando al OpenAPI, a los esquemas JSON y a las páginas de documentación; la tarjeta MCP con dos herramientas reales (validar un feed, leer cualquier página como Markdown) sobre transporte sin estado y sin autenticación; el índice de skills con dos entradas (una guía de adopción y una guía de publicación) con sus hashes y su licencia; los metadatos OAuth que declaran sin vergüenza que hay un solo credencial, y que lo que compra es una tasa mayor de validación, nada más; y cada página del sitio con su gemelo .md, porque el agente que prefiere Markdown no debería tener que parsear HTML.
Hay una vuelta que me gusta más que todo lo demás: el protocolo mismo vive en la carpeta. Un publicador de Cabuya declara su manifiesto en /.well-known/cabuya.json. La carpeta que describe el protocolo también lo ejecuta. Ese es el patrón de fondo de toda esta guía: cuando diseñes un protocolo, la carpeta te presta un cajón propio.
Medido, no declarado (que es la norma de la casa): el API de isitagentready devuelve nivel 5, Agent-Native, para cabuya.org: las 22 verificaciones pasan o cuentan como neutras, salvo la tarjeta A2A y el catálogo ARD, que el sitio no sirve.
¿Y el tráfico? Honestamente: no que yo pueda medir. Creo que publicar esta familia es una apuesta correcta y barata, no una lotería ganada — los formatos todavía compiten entre sí y ninguno tiene el monopolio de cómo llegarán los agentes. Pero una tarde de trabajo te deja dentro de la conversación, y no publicarte deja fuera de ella. El costo es asimétrico.
12. La guía que se prueba a sí misma
El último ejemplo de esta guía no está en internet: es la pestaña donde lees esto. El dominio en tu barra de direcciones sirve casi toda la familia que acabas de recorrer: Content Signals, Link headers, catálogo de APIs, metadatos OAuth, tarjeta MCP, índice de skills, WebMCP y el manifiesto ARD. Este mismo sitio que estás leyendo. El tablero lo mide en nivel 5, Agent-Native. Y sí: el visitante de las tres de la mañana con el que abrí el post encuentra sus instrucciones en este dominio todas las noches.
Pruébalo tú. La carpeta no se lista (eso sigue igual), pero cada archivo sí se abre. Durante un minuto, sé el agente:
| Ruta | Qué encuentra |
|---|---|
/.well-known/ai-catalog.json |
El manifiesto ARD de la sección 10: ocho recursos — el servidor MCP, la API pública, llms.txt, auth.md |
/.well-known/api-catalog |
El catálogo RFC 9727: OpenAPI, la guía para LLMs, el portal /developers |
/.well-known/mcp/server-card.json |
La tarjeta MCP: buscar posts, listar series, abrir uno por slug |
/.well-known/agent-skills/index.json |
El índice de skills |
/.well-known/oauth-authorization-server |
Los metadatos OAuth — el stub honesto, con su _comment a la vista |
/.well-known/oauth-protected-resource |
El recurso protegido que se apunta a sí mismo |
JSON crudo, a la vista de cualquiera — como el openid-configuration de Google, solo que este habla de un blog y no de credenciales.
Y un par de detalles que me gustan. La página que tienes abierta registró tres herramientas WebMCP en tu navegador al cargar (search_blog, list_series, open_post), así que si tu navegador ya habla navigator.modelContext, la sección 8 no te la conté: te la estoy demostrando. El registro DNS de la sección 10 también existe aquí: _index._agents.xergioalex.com responde antes de que se haga la primera petición HTTP. Y en robots.txt los Content Signals los escribe una sola capa — la mía — sin el conflicto de versiones que encontré en cabuya.org.
Medido, no declarado (la norma de la casa, otra vez): de las 22 verificaciones, xergioalex.com pasa 15; seis cuentan como neutras (Web Bot Auth y todo el eje de comercio; esto no es una tienda) y falla una: la tarjeta A2A. Cabuya.org falla dos, porque tampoco sirve el catálogo ARD. Sí: el blog personal le lleva una verificación al protocolo que construí específicamente para ser encontrado. Los estándares no preguntan para quién escribiste.
Te debía la parte honesta: varias de las trampas que te listé aquí las pisé en este dominio, antes de saber que eran trampas. El _comment de OAuth que recomendé en la sección 4 está en producción aquí porque aquí fue donde lo necesité. Las trampas de esta guía no son teoría; son mi diario de campo.
Con una tarde basta
Todo lo que acabas de leer se envía en una tarde. Las Content Signals son una línea en robots.txt; los Link headers son otra; los seis archivos JSON de la carpeta pesan, en su mayoría, menos de 1 KB. El spec OpenAPI es el único que toma tiempo, presupuesta media jornada, y el puente WebMCP puede esperar al fin de semana siguiente: de solo lectura la primera vez, como el mío.
Tampoco necesitas leer un solo RFC de principio a fin. Lee cada SKILL.md en isitagentready.com/.well-known/agent-skills/, copia su payload, ajusta las URLs. Los RFC explican por qué existe cada campo; el SKILL.md te dice qué poner. El camino largo ya lo caminó alguien por ti.
El segundo público
Durante treinta años construimos la web para un solo público: ojos humanos. Todo (el diseño, la navegación, el copy) existía para ser visto. Y en algún momento, sin anuncio, el público se duplicó. Llegaron lectores que jamás verán tu diseño. Solo leen — y deciden.
La carpeta lleva décadas recibiendo máquinas. robots.txt atendía crawlers antes de que existiera el navegador que usas ahora; openid-configuration hacía posible el botón de inicio de sesión con el que abrí esta guía. Lo nuevo no es que lleguen máquinas: es que por primera vez llegan a leer por su cuenta y a actuar sobre lo que leyeron. Eso es un visitante. Y a los visitantes se les dejan instrucciones.
No sé cuáles de estos formatos sobrevivirán. Pero el internet siempre fue lo mismo: acuerdos sobre dónde dejar las cosas para que el otro las encuentre. Nosotros solo estamos amueblando el cajón nuevo. Con menos de un kilobyte por archivo, tu sitio le habla a quien llegue — humano o no — en su propio idioma.
Sigo construyendo.
Recursos
- RFC 8615 — Well-Known URIs
- RFC 8288 — Web Linking
- RFC 9264 — Linksets
- RFC 9727 — API Catalog
- RFC 8414 — OAuth Authorization Server Metadata
- RFC 9728 — OAuth Protected Resource Metadata
- Model Context Protocol · SEP-1649 server card · draft IETF mcp://
- Cloudflare Agent Skills Discovery RFC · agentskills.io
- Spec WebMCP
- Content Signals · Web Bot Auth (IETF WG)
- isitagentready.com
- cabuya.org — el protocolo y su API pública de validación
Sergio Alexander Florez Galeano
CTO y Cofundador en DailyBot
Ingeniero de software y emprendedor colombiano (DailyBot, YC S21). Escribo sobre agentes de IA, herramientas para desarrolladores, startups y el arte de la ingeniería de software, y construyo este sitio a la vista de todos en XergioAleX.com.
Mantente al día
Recibe una notificación cuando publique algo nuevo. Sin spam, cancela cuando quieras.
Sin spam. Cancela cuando quieras.